高通在3月2日介绍AI200机架、加速卡和AI基础设施管理套件,并结合MWC相关演示说明其系统级设计。文章把计算、存储、互连与软件共同纳入推理平台,而不是只围绕某个独立加速器展开。
.com9.1.78关注这种组织方式,是因为模型进入服务后,需要面对持续请求与设备运行。能够完成一次推理演示,只说明基础能力具备可行性;当任务需要被反复处理,系统还要解决资源安排、状态观察和问题响应等工作。
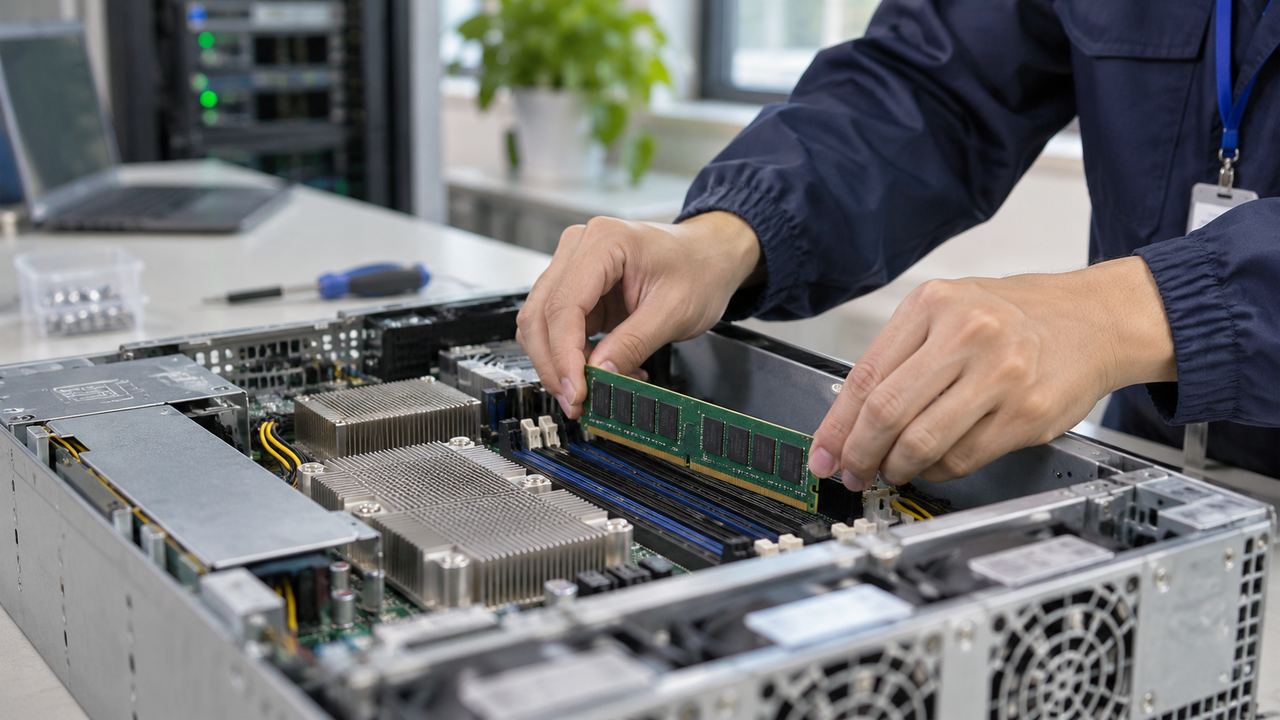
计算能力需要与数据供应配合
加速器处理任务时,需要取得相应的数据与模型内容。计算、存储容量和传输过程之间若不协调,某一部分的能力就可能难以在完整任务中体现。机架级设计所讨论的,正是这些部件如何形成共同工作方式。
这使性能评价需要包含具体任务条件。模型的组织方式、请求到达节奏和处理目标改变之后,系统面对的压力也会变化。单个部件的指标有参考价值,但要解释完整服务,还应说明数据怎样到达计算位置,以及结果怎样离开处理流程。
互连决定部件怎样组成整体
当多个计算与存储部分共同参与任务,互连不再只是连接线缆的问题。系统需要约定交换什么信息、怎样组织传输,以及各部分状态变化后如何协调。硬件布局与软件流程必须相互对应,才能形成可以管理的整体。
开发团队也需要观察任务在不同阶段花费了什么时间。等待可能出现在数据供应、资源排队或结果交接等位置。把这些阶段分开记录,有助于判断系统应调整哪里,而不是仅凭某个环节的变化推断整个平台已经改善。
资源扩展同样需要这种观察。增加设备可以提供更多可用能力,但工作怎样被分配、不同部分是否保持协调,仍取决于系统组织。扩展之后的实际表现,应通过完整任务验证,而不是简单按部件数量推算。
管理套件承担持续运行的工作
原文把配置、监控、编排与故障处理列为管理软件的作用。这些工作决定基础设施怎样进入可使用状态,以及运行过程中怎样被维护。对于长期提供服务的系统,它们与模型执行本身同样属于部署的一部分。
例如,某台设备出现异常时,管理层需要帮助识别受影响的任务与配置;版本变化之后,也需要保留对应记录。能够把问题关联到具体设备和运行状态,会让维护更有依据,而不是依赖对整体结果的猜测。
从演示到部署,要检验完整流程
高通将AI200相关进展与客户部署和后续路线图联系起来。阅读这类信息时,需要区分已经展示的系统能力、公告中的部署安排与进一步的产品计划。不同阶段提供的证据并不相同,也不应被合并成一个笼统结论。
对于使用者,较完整的评价可以从任务开始一直跟到结果返回:资源如何准备,请求怎样进入系统,异常怎样被记录,恢复后如何继续。这些问题能够说明平台是否容易被实际使用,也使不同方案的比较有更清楚的条件。
长期运行还需要关注变化。业务输入、模型版本和设备配置都会更新,管理流程必须帮助团队看清这些变化对既有服务的影响。可以持续解释系统行为,比一次达到较好的演示结果更接近基础设施的工作要求。
AI200文章所体现的方向,是把推理能力放回完整机架与软件体系中理解。后续更有价值的信息,将来自硬件、互连与管理流程如何共同支持具体任务。只有这些环节形成可检查的协作,平台能力才容易转化为稳定的服务。